Arquitetura de um Encurtador de URL
Publicado em
Tenho acompanhado poucos canais no youtube, mas um que sempre que eu vejo eu fico satisfeito é o do Renato Augusto.
Recentemente vi o vídeo sobre o encurtador de URLs que ele fez. Num geral, não tem como discutir que a solução dele é provavelmente a melhor possível dadas as premissas do problema:
Requisitos Funcionais:
- Encurtamento de URL: dado um URL longo -> retornar URL muito mais curto
- Redirecionamento de URL: dado um URL mais curto -> redirecionar para o URL original
Requisitos não funcionais:
- O sistema deve suportar 100 milhões de URLs geradas por dia
- O tamanho da URL encurtada deve ser o mais curto possível
- Somente números (0-9) e caracteres (az, AZ) são permitidos na URL
- Para cada 1 operação de gravação no banco de dados, haverão 10 operações de leitura
- O comprimento médio das URLs armazenadas é de 100 bytes
- URLs devem ser armazenadas pelo período mínimo de 10 anos
- O sistema deve operar em modo de alta disponibilidade (24/7)
Estimativas
- Operações de gravação: 100 milhões de URLs por dia = 100.000.000 / 24 / 60 /60 = 1160 requisições por segundo
- Operações de leitura: 10:1 = 1160 * 10 = 11600 requisições por segundo
- Tempo de armazenamento das URLs: 10 anos = 100.000.000 * 365 * 10 = 365 bilhões de registros
- Capacidade de armazenamento: 100 bytes por URL = 365 bilhões * 100 bytes = 46,5 TB
Com essas premissas, ele montou uma arquitetura usando Cassandra para armazenar as URLs, Redis para o auto increment e cache, e uma função que faz um base62 ofuscado com hashid para gerar a url minificada.
Vai lá ver o vídeo. Coisa boa.
Elegante. Fiquei pensando um tempo e acho que a parte do base62 é realmente a melhor solução nesse caso. É simples, robusto, auto-contido e (tirando o redis) sem “partes móveis”.
Num mundo ideal, a solução dele é a melhor. O problema é que normalmente temos algumas restrições sobre quais tecnologias usar, principalmente se já estamos trabalhando em uma empresa consolidada. Tendo isso em mente, irei expandir os requisitos, adicionando um hipotético:
- a empresa usa banco de dados MariaDb, e a equipe de DBA não aprovou a utilização de Cassandra
Essa restrição gera o que, para mim, é a grande dificuldade do sistema descrito. Cassandra estava resolvendo o principal gargalo arquitetural da coisa toda:
1160 requisições de escrita por segundo
Na leitura podemos otimizar os cache-hits (mesmo se não fosse redis), na geração do id podemos seguir com o caminho do base62(a mesma lógica poderia ser reaplicada em qualquer linguagem), mas o problema da escrita estávamos (corretamente) delegando para um banco preparado para esse volume, e, ao remove-lo do desenho, agora precisamos lidar com isso.
Inclusive, no “dia a dia normal” de sistemas web, esse é o gargalo que mais convivemos: sobrecarga do banco de dados. A menos que sua aplicação possua algum comportamento atípico, os principais mecanismos e padrões usados são para evitar hits desnecessários no banco. Na leitura, alguma estrutura de cache é sempre útil, mas e quando você precisa de muita escrita?
E, para evitar “roubar” usando algum artifício específico do MariaDB, vou atacar o problema considerando o banco de dados sem muitas customizações/otimizações, de forma a resolvermos o problema de forma arquitetural, mesmo se o banco fosse algum outro sql-like.
O problema
Não é só uma questão de otimizar as escritas quando temos esse cenário: qualquer turbulência no banco irá impactar diretamente a aplicação, seja rotina de backup, outro processo roubando um pouco do servidor, ou mesmo manutenções de fato. A questão é tentar aumentar a disponibilidade da aplicação mantendo o principal gargalo fora do circuito quente.
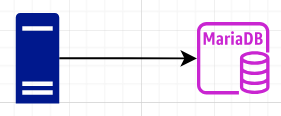
Segue um exemplo do caminho síncrono padrão. Faça um teste de carga usando o endpoint sincrono, aumente os números e cause alguma instabilidade no banco de dados. É isso que irá acontecer em produção, e quem sofre é o usuário.
Existem n formas de atacar isso, vamos abordar algumas abaixo:
Escrita assíncrona com consistência eventual
Já falei bem por cima sobre isso nesse outro artigo. A ideia aqui é responder rápido para o cliente, mas não com a resposta final, e sim com um compromisso de execução. O cliente faz o POST, retornamos com um status no range de 200, e o cliente pode fazer um polling para confirmar quando a aplicação terminou seu processamento.
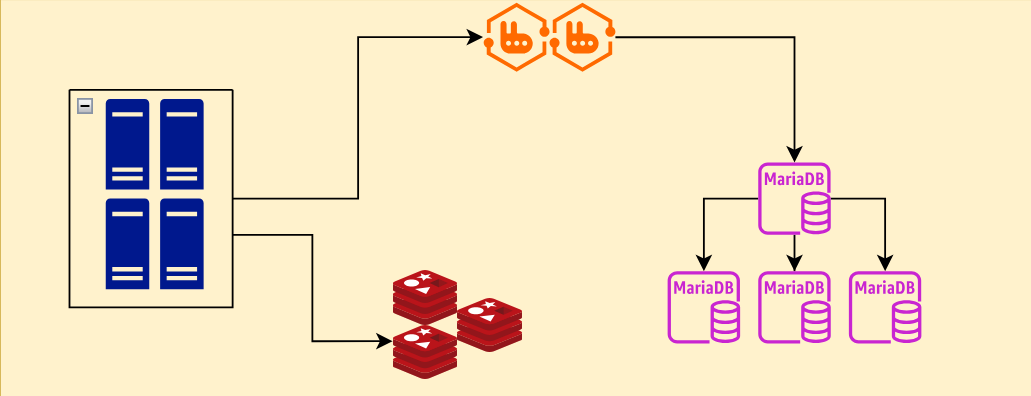
Segue um exemplo, usando rabbitmq como fila de processamento.
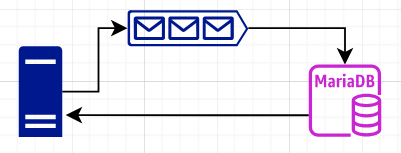
Repare que aqui temos dois mecanismos distintos agora: um que recebe a requisição do cliente, e um que processa a fila de requisições. Isso significa que podemos otimizar as duas pontas separadamente. Podemos inclusive ter um mecanismo de aumentar o número de consumidores da fila de forma automática, caso ela comece a crescer, e podemos fazer isso respeitando os limites do banco. Isso permite que a sua aplicação permaneça minimamente responsiva, mesmo em casos onde o banco esteja instável.
Nesse cenário de encurtador de URL, há um ponto arquitetural interessante: não há um processamento pesado para gerar urls (graças ao elegante mecanismo com base62 de correspondência direta entre o id incremental e a url encurtada). Isso permite que, na requisição inicial do cliente, já seria teoricamente possível retornar qual a URL encurtada.
O problema disso é que, com a fila no meio do caminho, temos um cenário onde, na resposta do POST já retornaríamos a url encurtada, mas ela ainda não está disponível no banco de dados, o que fará nosso GET falhar, e isso nos leva ao próximo padrão arquitetural:
Escrita assíncrona com write-behind cache
Já que temos a “url final” só com o id incremental, podemos colocar em cache “coisas a escrever”, de forma que, mesmo no período antes da requisição da fila ser consumida, sua aplicação já pode responder corretamente um GET. Isso te dá todo o benefício dos dois mecanismos distintos apontados anteriormente, mas aumenta sua auto suficiência.
Seu cache fica mais poluído, pois precisa lidar com dois tipos de dados, e é preciso um cuidado extra com o que pode ser removido automaticamente do cache ou não. Além disso, precisamos de mais um mecanismo no consumidor da fila para fazer uma “promoção” do cache que antes estava ainda a ser persistido no banco para uma entrada de cache comum.
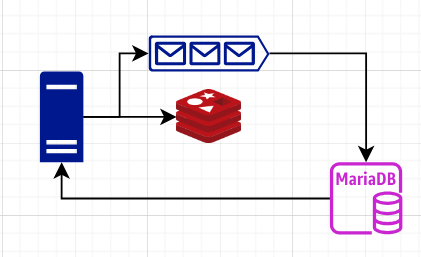
Repare que a complexidade operacional aumentou significativamente. Isso nunca é uma coisa boa, mas aumentou a disponibilidade e robustez da aplicação. Segue um exemplo de implementação aqui.
Nesse cenário, se tiver um cache de leitura bem configurado, sua aplicação fica de pé mesmo se o banco cair. Claro, não vai responder tudo corretamente, pois nem tudo vai estar em cache, mas te permite escapar do temido “100% indisponível”. Importante lembrar também que esse só conseguimos prover esse cenário de forma completa, sem o banco de dados, devido a externalidade do id incremental, e da natureza simples de processamento do problema em questão.
Há um argumento a ser feito aqui: por que precisamos da fila, se o cache de escrita já tem a informação ali? Não seria mais fácil ter alguma rotina que de tempos em tempos faz o flush do cache para o MariaDB?
A resposta simples é não. A fila está resolvendo um papel crucial: durabilidade em alto volume de escrita. Se a sua aplicação é “padrão”, perda de dados não é aceitável, e embora um cache em cluster vai te entregar alta disponibilidade, dados em memória são dados efemeros. É preciso escrever em algo durável para garantir a consistência do storage final.
Agora, se para o seu cenário algum nível de perda de dados é aceitável…
Memória como Storage Primário e Consistência Periódica
Já que o volume de throughput necessário é muito agressivo, e queremos simplificar a arquitetura minimizando o número de componentes envolvidos, podemos colocar os dados em memória e considerar a memória como a fonte primária de dados.
A ideia aqui é ter um cache grande com os dados quentes (tanto de escrita quanto de leitura) e um mecanismo periódico de escrita desses dados em um storage durável. Esse storage durável pode ter os dados históricos também, então caso algo não esteja no cache, podemos buscar no banco, mas as escritas vão direto para o cache, e de tempos em tempos, fazemos o flush disso para o banco.
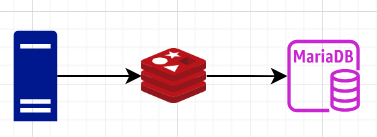
Veja que, nesse cenário, há uma janela onde dados podem ser perdidos, caso o cache caia. Para um encurtador de URL isso não é aceitável, mas há situações onde essa volatilidade pode te trazer a velocidade necessária, com complexidade baixa e risco moderado.
Como recomendação geral, é um “evite”, mas use seu bom senso.
Há outras formas, como event sourcing por exemplo, mas isso já é conteúdo para outro post.
Comentários
Sinto que os comentários em blogs têm diminuído com o passar do tempo. Se você tiver alguma dúvida ou quiser falar sobre o post, entre em contato comigo pelos links abaixo.